Insight
국산 모델 확산의 다음 단계는 왜 ‘성능’이 아니라 ‘현장 적용률’인가
벤치마크 점수만으로 국산 모델의 차별점이 부각되지 않는다
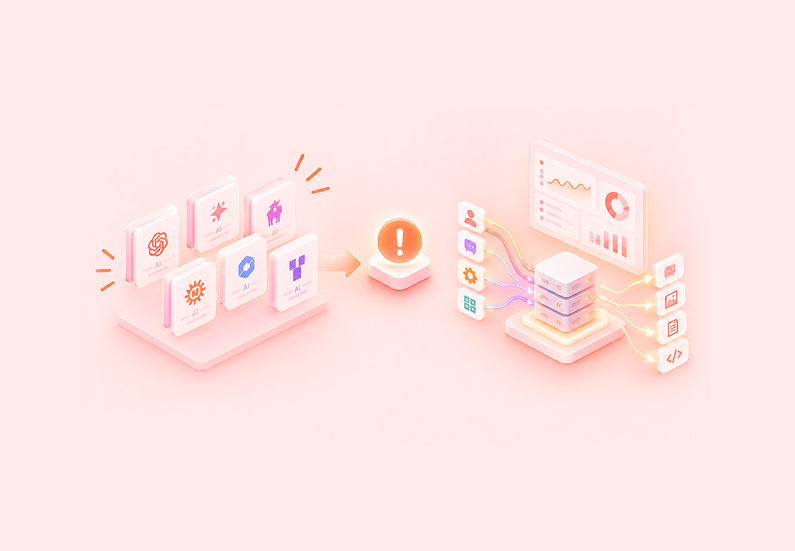
국산 모델의 성능 경쟁은 이미 글로벌 무대에서 진행되고 있습니다. 글로벌 AI 모델 추적기관 에포크 AI의 ‘주목할 만한 AI 모델’ 리스트(2025년 7월 기준)에는 국내 모델 16개가 이름을 올렸고, 업스테이지 솔라 프로2는 글로벌 지능 지표에서 중국 딥시크와 프랑스 미스트랄을 제쳤습니다. 네이버의 오픈소스 모델 하이퍼클로바X 시드는 공개 3개월 만에 허깅페이스 누적 다운로드 100만 건을 넘겼고, 3B 모델은 한 달간 58만 회 이상 다운로드되며 등록 모델 약 187만 개 중 상위 0.02%에 올랐습니다. 그러나 국산 모델이 잇달아 상위권에 오를수록 모델 간 점수 차는 좁아지고, 점수만으로는 어떤 모델이 조직에 더 적합한지 가려내기 어려워집니다.
벤치마크와 현장 사이에는 간극이 있다
실증 데이터도 같은 방향을 가리킵니다. 한국은행의 AI 활용 실태 조사(2025)에 따르면 국내 근로자의 63.5%가 생성형 AI를 사용했고, 업무 목적 사용은 51.8%로 미국(26.5%)의 두 배입니다. 사용 확산 속도는 세계 상위 수준입니다. 그러나 AI 활용으로 측정된 잠재 생산성 향상폭은 1.0%에 머물렀고, AI를 써도 업무시간이 줄지 않았다는 응답은 54.1%에 달했습니다.
개인의 AI 활용은 빠르게 늘었지만 조직의 성과로 이어지지 못하는 이유는, 모델의 성능보다 모델을 둘러싼 운영 환경에서 찾을 수 있습니다. 벤치마크는 정해진 문제를 한 번 푸는 평가이지만, 실제 업무 현장은 데이터와 권한, 자원, 보안, 업무 프로세스가 얽힌 연속적인 운영으로 이루어지기 때문입니다.
현장 적용을 가로막는 요구는 계속 늘어난다
과제는 여기서 끝나지 않습니다. 2026년 1월부터 시행된 AI 기본법은 고영향 AI의 안전성과 투명성 관리 요구를 높였고, 아마도 규제 요구는 앞으로도 계속 늘어날 것입니다. 여기에 오픈소스 모델이 빠르게 공개될수록 새 모델 도입 주기도 짧아지고 있습니다. 조직은 모델이 바뀔 때마다 같은 과제를 다시 반복해서 검증해야 하는 상황에 놓입니다. 과제의 중심이 모델을 ‘한 번 도입하는 것’에서 ‘계속 운영하는 것’으로 이동하고 있습니다.
현장 적용률은 모델 다음의 운영 환경에서 결정된다
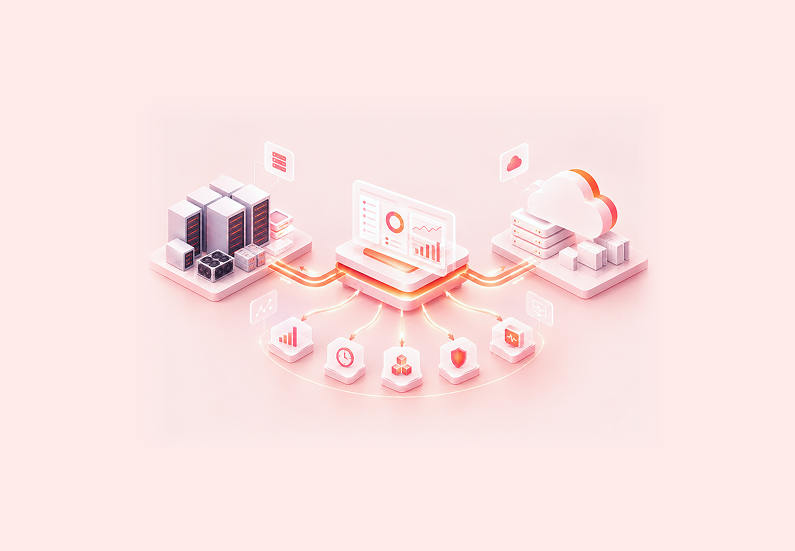
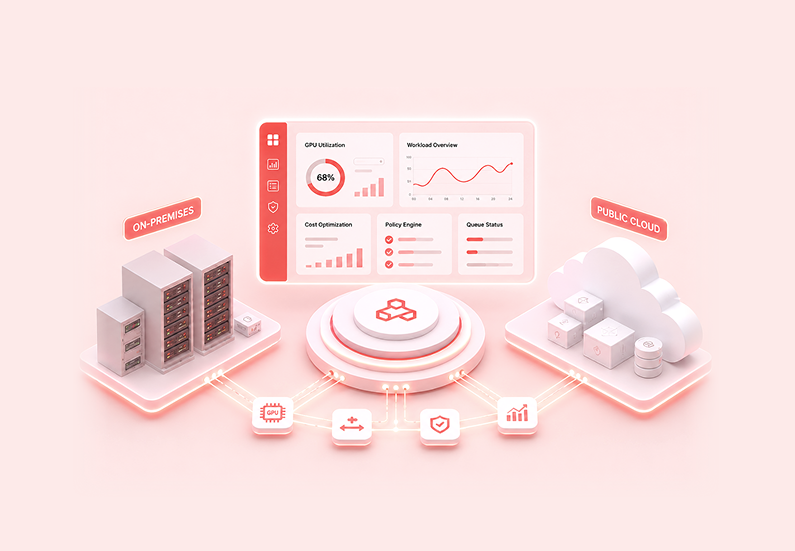
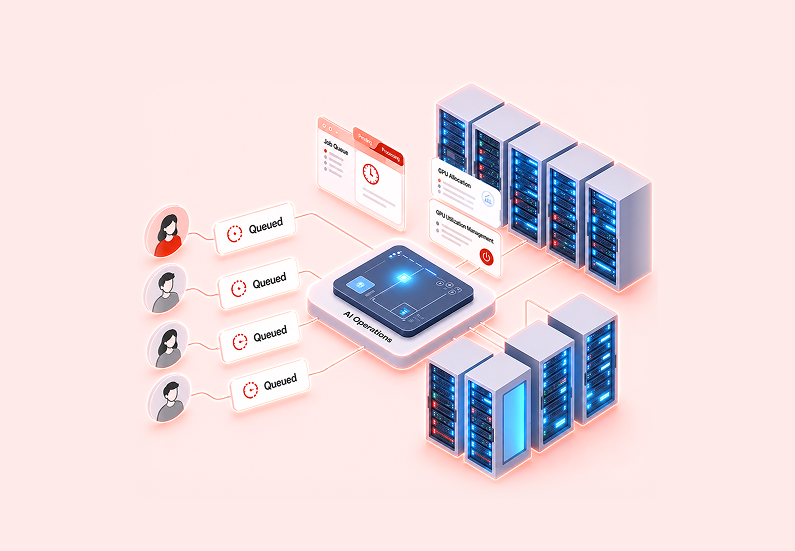
모델이 실제 업무에 안정적으로 들어가 오래 운영되려면 세 가지 조건이 필요합니다. 여러 모델을 같은 환경에서 배치, 비교, 교체할 수 있는 운영 플랫폼, 인프라 설정 걱정 없이 누구나 동일하게 모델과 자원에 접근하는 표준화된 접근 환경, 그리고 데이터, 권한, 자원을 프로젝트 기준으로 관리하는 운영 체계입니다. 클루닉스가 강조해 온 운영 플랫폼, 표준화된 접근 환경, 프로젝트 단위 운영 체계는 안정적인 운영이라는 현장의 과제를 해결하기 위한 필수 기능입니다. 현장 적용률은 어떤 모델을 선택했는가보다, 선택한 모델을 어떤 환경에서 운영하는가에 더 크게 영향을 받습니다.
승부처는 성능 점수가 아니라 운영 지속성이다
국산 인공지능 모델 경쟁의 핵심이 벤치마크 점수에서 '실제 업무 적용력'과 '장기 운영 안정성'으로 전환되고 있습니다. 모델의 평가 점수가 높더라도 실제 서비스에서 비용 효율적이고 안정적으로 운영될 수 있어야 합니다. 따라서 앞으로는 모델 선택을 넘어, 해당 모델이 기업 환경에 얼마나 쉽게 도입되고 오랫동안 안정적으로 구동될 수 있는지 파악하는 운영 완성도가 가장 중요한 기준이 될 것입니다.