Insight
학습과 추론 인프라는 왜 GPU 운영 기준을 따로 설계해야 하는가
추론이 AI 컴퓨팅의 중심으로 이동하는 흐름
Deloitte는 AI 컴퓨팅에서 추론이 차지하던 비중이 2023년 약 3분의 1에서 2026년은 약 3분의 2로 확대될 것으로 전망했습니다. 또한 추론 대부분이 엣지가 아닌 데이터센터에서 처리될 것으로도 내다봤습니다. 이에 학습 중심으로 쌓아 온 운영 방식이 컴퓨팅의 다수를 차지하는 추론에도 적용되는지 점검할 필요가 커지고 있습니다. 같은 GPU를 쓰더라도 두 워크로드가 자원을 요구하는 방식은 서로 다르기 때문입니다.
학습 작업은 왜 자원이 모두 확보되어야 시작되는가
분산 학습에 참여하는 파드(애플리케이션을 실행하는 가장 작은 배포 단위)는 상호 의존적으로 동작하기에 모든 파드가 동시에 시작되어야 합니다. 또한 GPU 간 통신 대역폭이 충분한 노드에 함께 배치되어야 합니다. 그러나 쿠버네티스 기본 스케줄러는 파드를 개별적으로 스케줄링합니다. 예를 들어 워커 16개가 필요한 학습 작업에서 GPU 4개만 비어 있다면, 4개가 먼저 시작되고 나머지 12개는 대기 상태에 놓일 수 있습니다. 이때 먼저 할당된 GPU 역시 나머지 자원을 기다리느라 실제 연산에 활용되지 못합니다.
이에 따라 분산 학습 환경에서는 개별 파드의 빠른 배치보다 작업에 필요한 자원을 모두 확보한 뒤 일괄 실행하는 스케줄링 방식이 중요합니다.
추론에서는 요청별 응답 시간이 운영의 기준이 된다
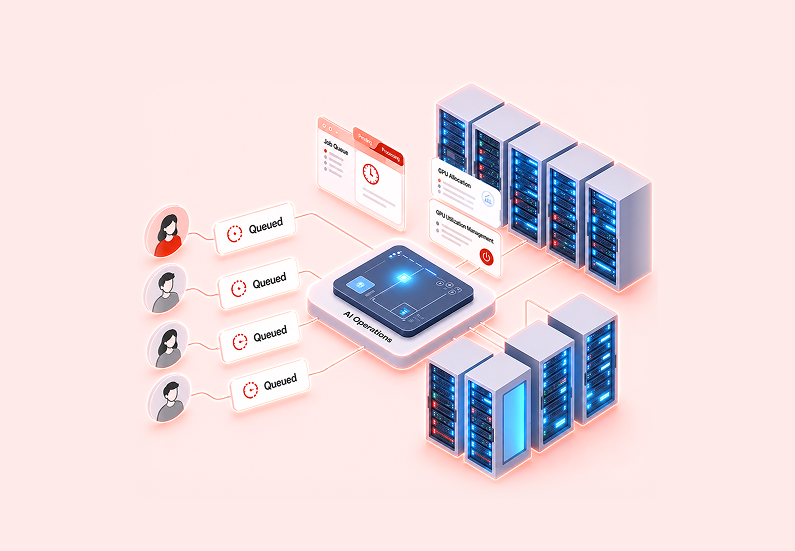
반면 LLM 추론 서비스는 챗봇, 코딩 어시스턴트, AI 검색 등 응답 지연에 민감한 애플리케이션을 지원합니다. 요청마다 입력 길이와 우선순위, 응답 목표가 다르며, 빠른 처리가 필요한 실시간 요청과 처리량을 중시하는 배치형 요청이 동시에 유입됩니다.
이 과정에서 처리량을 높이면 응답 지연이 늘어나고, 지연을 줄이면 GPU 운영 비용이 증가하는 상충 관계도 고려해야 합니다. 따라서 학습이 개별 작업의 안정적인 완료에 초점을 맞춘다면, 추론은 변동하는 요청을 각 서비스의 응답 목표에 맞춰 효율적으로 처리하는 것이 핵심 기준이 됩니다.
자원을 나누는 방식에서 차이가 나는 학습과 추론
자원 배분 방식에서도 차이가 나타납니다. 학습은 여러 노드의 GPU를 큰 단위로 묶어 일괄 확보하는 반면, 추론은 요청 규모와 서비스 특성에 맞춰 GPU를 세분화하고 여러 서비스에 분산 배분하는 방식에 가깝습니다.
NVIDIA는 GPU 하나를 최대 7개의 독립 인스턴스로 분할하는 MIG 기술을 소개하며, 낮에는 7개 인스턴스로 추론 서비스를 운영하고 밤에는 하나의 대형 인스턴스로 재구성해 학습에 활용하는 사례를 제시합니다. 이는 동일한 GPU도 시간대와 워크로드에 따라 자원 구성을 유연하게 전환할 수 있음을 보여줍니다.
하나의 운영 정책으로 두 워크로드를 감당할 수 있는가
두 워크로드를 동일한 운영 기준으로 관리하면 각 환경의 특성이 반영되지 않아 비효율이 발생할 수 있습니다. 학습 중심의 기준을 추론에 적용하면 즉각적인 응답이 필요한 요청이 대규모 작업에 밀려 대기할 수 있고, 반대로 추론 중심의 기준을 학습에 적용하면 일부 자원만 할당된 작업이 나머지 자원을 기다리며 유휴 상태에 놓일 수 있습니다.
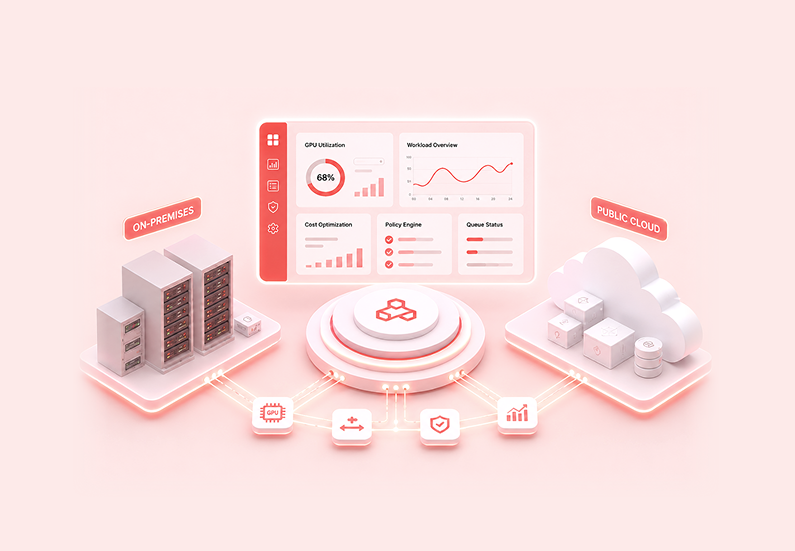
클루닉스가 강조해 온 워크로드별 자원 배분, 사용자·프로젝트 단위의 우선순위 조정, 운영 정책 분리 설계는 이러한 차이를 고려해 하나의 인프라 안에서도 학습과 추론에 서로 다른 자원 운영 정책을 적용하기 위한 기능입니다.
학습과 추론의 운영 기준은 이제 따로 설계되고 있다
추론 비중이 확대되면서 학습과 추론은 동일한 GPU 인프라를 사용하더라도 서로 다른 운영 기준을 요구하고 있습니다. 학습은 필요한 자원을 일괄 확보하는 것이 중요하고, 추론은 요청별 응답 목표와 우선순위에 맞춰 자원을 배분하는 것이 핵심입니다. 결국 인프라 경쟁력은 단순한 장비 규모를 넘어, 보유한 GPU를 워크로드 특성에 맞춰 얼마나 효율적으로 운영하는지에서 결정됩니다.